

Toda aplicación necesita ser probada, y toda prueba necesita datos. Sin embargo, el generar buenos datos de prueba es una de esas tareas que se subestima hasta que se convierte en un problema. Los equipos, o bien utilizan datos de producción y se topan con problemas de privacidad y cumplimiento normativo (compliance), o bien crean a mano un puñado de filas que apenas rascan la superficie de lo que la aplicación realmente encontrará en el mundo real. Ninguno de los dos enfoques escala, y ambos dejan lagunas en la cobertura de las pruebas (test coverage) que tienden a salir a la luz en el peor momento posible. Este artículo defiende la inversión en una generación adecuada de datos de prueba y muestra cómo las herramientas integradas de Navicat pueden hacer que el proceso sea significativamente más rápido y fiable.
Por qué es importante la calidad de los datos de prueba
El propósito de los datos de prueba es ejercitar tu aplicación en condiciones que se asemejen estrechamente a un entorno real de producción. Si tu conjunto de datos (dataset) de prueba es demasiado pequeño, los casos límite (edge cases) se quedan sin probar. Si los datos no son realistas (IDs secuenciales, cadenas lorem ipsum, fechas uniformes), la aplicación puede comportarse de manera diferente a como lo hará con valores reales. Y si los datos violan las relaciones y restricciones (constraints) definidas en tu esquema, las pruebas o bien fallan de forma espuria o, peor aún, pasan silenciosamente porque los datos eran demasiado limpios como para activar los fallos (bugs) que deberían haber detectado.
Un volumen realista también es crucial para las pruebas de rendimiento (performance testing). Una consulta (query) que se ejecuta en milisegundos contra mil filas puede comportarse de manera muy diferente contra un millón. Sin un dataset representativo, los problemas de rendimiento que serían obvios en producción permanecen invisibles durante el desarrollo.
Por qué no deberías usar datos de producción
La tentación de copiar datos de producción a un entorno de pruebas es comprensible; es el dataset más realista que tienes y ya existe. Pero para la mayoría de las organizaciones, este enfoque no es ni seguro ni legal. Normativas como el RGPD (GDPR) y la HIPAA imponen controles estrictos sobre dónde se pueden almacenar los datos personales y quién puede acceder a ellos. Un entorno de pruebas accesible para desarrolladores, ingenieros de QA y contratistas rara vez cumple con esos controles. Más allá del compliance, los datos de producción en un entorno de pruebas crean un riesgo real de exposición accidental, modificación o eliminación de registros reales de clientes activos.
El enfoque correcto consiste en generar datos sintéticos que coincidan con la estructura, la variedad y la distribución estadística de los datos de producción, sin contener absolutamente nada de ellos.
Los retos de generar datos a mano
Escribir scripts o sentencias SQL para poblar tablas de prueba a mano es tedioso y propenso a errores en cualquier esquema que no sea trivial. Los retos se acumulan rápidamente: los valores deben coincidir con el tipo de datos y las restricciones de cada columna, se deben respetar las relaciones de claves foráneas (foreign keys) para mantener la integridad referencial en todas las tablas, y los datos deben ser lo suficientemente variados como para resultar significativos. Si haces esto en diez o quince tablas relacionadas, el esfuerzo manual se vuelve lo bastante importante como para que los equipos, a menudo, se lo salten por completo y, como resultado, realicen pruebas con datos inadecuados.
La herramienta para generar datos de Navicat
Navicat Premium incluye una herramienta integrada de Genereación de Datos (Data Generation, accesible desde el menú Herramientas) que aborda estos desafíos directamente. Está diseñada para generar grandes volúmenes de datos de prueba realistas a través de múltiples tablas relacionadas, guiada por un asistente (wizard) de varios pasos que gestiona la complejidad del proceso.
El asistente comienza permitiéndote seleccionar la base de datos de destino y elegir qué tablas poblar. De manera crucial, te permite controlar el orden en el que se pueblan las tablas, de modo que las restricciones de clave foránea se satisfagan correctamente (es decir, las tablas padre se llenan antes que las tablas hijo que hacen referencia a ellas). Este es uno de los puntos de fallo más comunes al generar datos de prueba manualmente, y Navicat lo gestiona explícitamente en lugar de dejar que el desarrollador tenga que resolverlo.
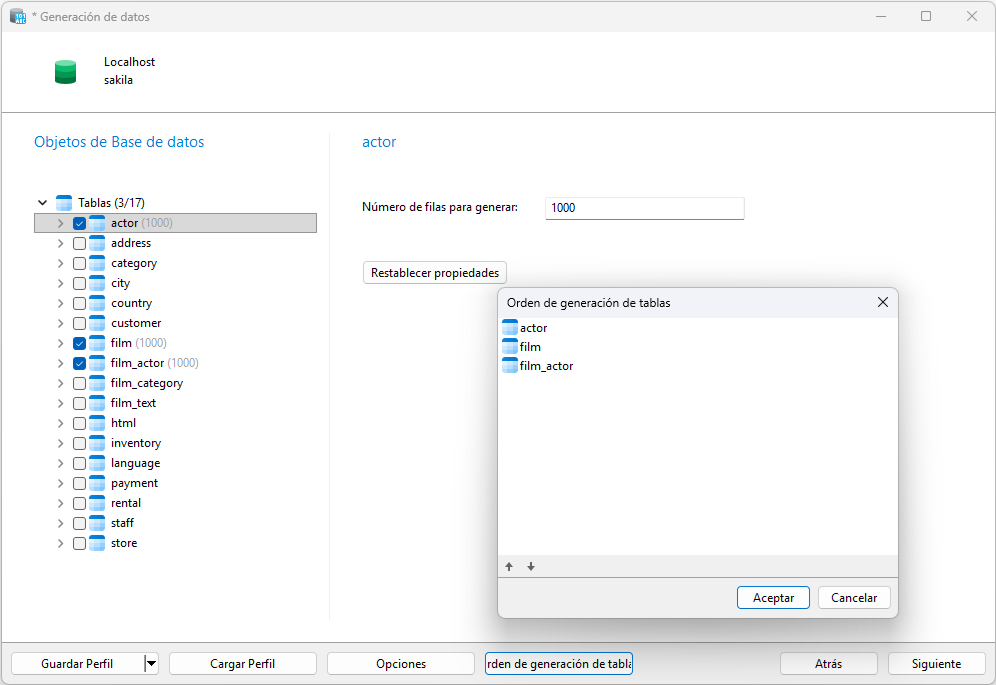 Para cada columna en cada tabla seleccionada, configuras el tipo de datos a generar. Navicat proporciona generadores adaptados a patrones y tipos de datos comunes: rangos numéricos, rangos de fechas, cadenas (strings) con formatos definidos y más. Esto significa que los valores generados no son simplemente ruido aleatorio; reflejan la estructura y las reglas de negocio de tu esquema. Puedes aplicar restricciones y reglas por columna para garantizar que el resultado (output) coincida con lo que tu aplicación encontrará realmente.
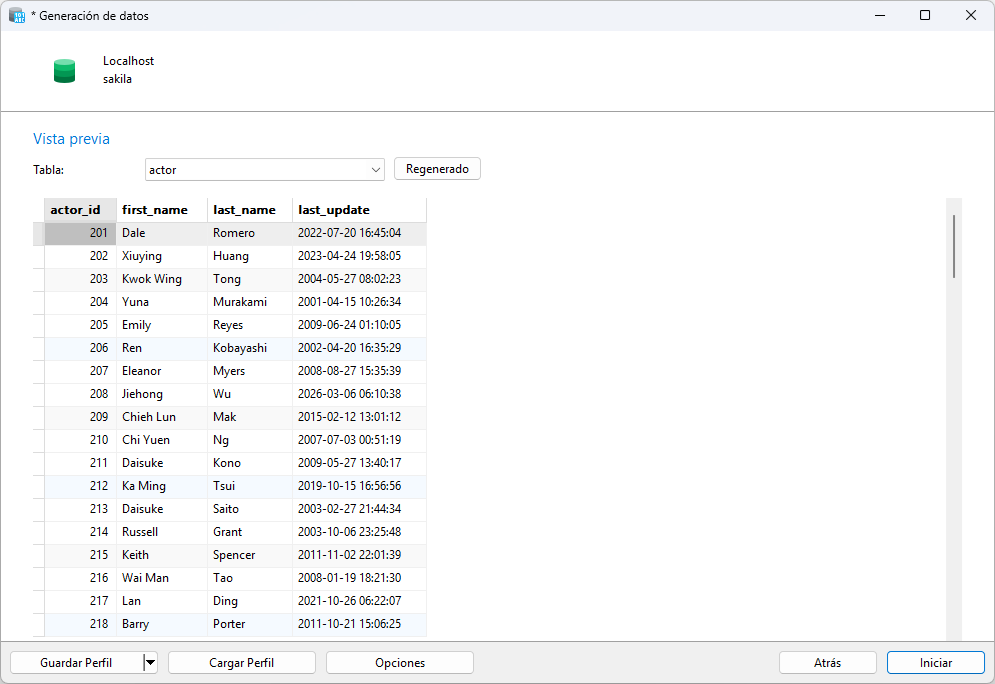
Una vez completada la configuración, Navicat muestra una vista previa detallada de los datos que tiene previsto generar antes de escribir nada en la base de datos. Puedes revisar los valores y volver a generar los datos de cualquier tabla si no parecen correctos. Este paso de vista previa es particularmente útil para detectar generadores mal configurados antes de que pueblen una tabla con miles de filas inútiles.
La herramienta está disponible en todas las bases de datos soportadas por Navicat, incluyendo MySQL, PostgreSQL, SQL Server, Oracle, MariaDB, SQLite, MongoDB y Snowflake, y el flujo de trabajo es coherente independientemente del motor (engine) al que te dirijas. Para los equipos que trabajan en múltiples plataformas de bases de datos, esto significa una única herramienta familiar en lugar de un script o utilidad independiente por cada tipo de base de datos.
Integrar la generación de datos en tu flujo de trabajo
La generación de datos de prueba funciona mejor cuando se trata como un paso repetible y documentado en tu proceso de desarrollo, en lugar de como una tarea puntual. La configuración ideal es aquella que se puede volver a ejecutar siempre que cambie el esquema o sea necesario sembrar (seed) un entorno de pruebas nuevo. El asistente de Generación de Datos de Navicat apoya esto permitiéndote guardar y reutilizar configuraciones de generación, de modo que el esfuerzo invertido en configurar los generadores adecuados y el recuento de filas para tu esquema no se pierda entre ejecuciones.
Un flujo de trabajo práctico consiste en emparejar la generación de datos con la duplicación de esquemas: utiliza la herramienta de Sincronización de Estructura (Structure Synchronization) de Navicat para replicar el esquema de tu base de datos de producción en un entorno de pruebas limpio, y luego utiliza la herramienta de Generación de Datos para poblarlo con datos sintéticos. El resultado es un entorno de pruebas que refleja la estructura de producción de forma idéntica sin contener ninguno de sus datos.
Conclusión
Unos buenos datos de prueba no son un lujo, son un requisito previo para que las pruebas tengan un verdadero sentido. Generarlos a mano no escala, y el uso de datos de producción está descartado para la mayoría de las organizaciones que operan bajo cualquier tipo de normativa de privacidad de datos. Una herramienta diseñada a medida como el asistente de Generación de Datos de Navicat elimina la mayor parte de la sobrecarga (overhead) manual: gestiona la integridad referencial, proporciona un control por columna sobre el tipo y la forma de los valores generados, muestra una vista previa antes de hacer el commit definitivo, y funciona de manera consistente en los motores de bases de datos que tu equipo probablemente esté utilizando. El resultado son datos de prueba realistas que respetan las restricciones sin el esfuerzo manual que, por lo general, hace que la generación adecuada de datos de prueba parezca que no vale la pena.